Inhaltsverzeichnis
Inhaltsverzeichnis- KI in der Lieferkettenplanung erfolgreich einsetzen: Warum eine solide Datenbasis entscheidend ist
- Was KI in der Lieferkettenplanung tatsächlich leisten kann
- So werden Daten zu fundierten Entscheidungen: der Prozess in 5 Schritten
- Beginnen Sie mit der Entscheidung, nicht mit dem Modell
- Die Datenbasis: Was zuerst vorhanden sein muss
- Die Menschen mitnehmen: Disponenten und KI im Zusammenspiel
- KI-gestützte und autonome Planung sind zwei verschiedene Dinge
- Drei Fragen, bevor Sie KI in der Lieferkettenplanung einsetzen
Überblick
KI kann die Lieferkettenplanung intelligenter, schneller und reaktionsfähiger machen, aber Technologie allein reicht nicht aus. Wir zeigen, wie KI Entscheidungen bei Absatz, Bestand und Beschaffung unterstützt und warum verlässliche Daten, klare Prozesse und menschliche Expertise entscheidend bleiben.
KI in der Supply-Chain-Planung bedeutet, Modelle einzusetzen, die aus Daten lernen oder riesige Mengen an Optionen durchsuchen, um bei konkreten Planungsentscheidungen zu helfen. Dazu zählen etwa die Fragen, wie hoch der zu erwartende Absatz ist, wie viel Bestand wo vorgehalten werden soll und was wann bei welchem Lieferanten bestellt werden muss. Ich finde es sinnvoller, KI über die Entscheidungen zu definieren, die sie verbessert, und nicht über die Technologie. Sie zahlt sich nur aus, wenn diese Entscheidungen bereits auf funktionierenden Daten und Prozessen beruhen.
In diesem Beitrag möchte ich untersuchen, was KI in einem Planungsprozess tatsächlich leistet, wie die einzelnen Bausteine zusammenspielen und was vorhanden sein muss, damit sich der Nutzen in den Ergebnissen zeigt.
Was KI in der Lieferkettenplanung tatsächlich leisten kann
Anstatt KI als ein einziges Thema zu betrachten, halte ich es für hilfreicher, die Entscheidungen in den Blick zu nehmen, die sie unterstützt. In den meisten Planungsteams lassen sich diese in drei Gruppen einteilen.
- Absatz. Den zukünftigen Absatz nach Artikel, Kunde und Standort prognostizieren, erkennen, wann sich ein Muster tatsächlich verändert hat und nicht nur geschwankt hat, und eine einmalige Bestellung von einem neuen Trend unterscheiden.
- Bestand. Artikel nach ihrem Verhalten gruppieren, Servicelevel und Sicherheitsbestände je Gruppe festlegen und entscheiden, wo im Netzwerk der Bestand liegen soll.
- Beschaffung. Wann und wie viel bestellt werden soll, wie man reagiert, wenn sich die Wiederbeschaffungszeiten oder die Liefertreue eines Lieferanten ändern, und ob man die Bestellung beschleunigt, Bestände umlagert oder ein kurzfristiges Servicerisiko in Kauf nimmt.
Wird Ihnen eine KI-Funktion vorgestellt, die sich keiner dieser Entscheidungen und keinem Entscheidungsträger zuordnen lässt, würde ich bezweifeln, dass sie viel verändert.
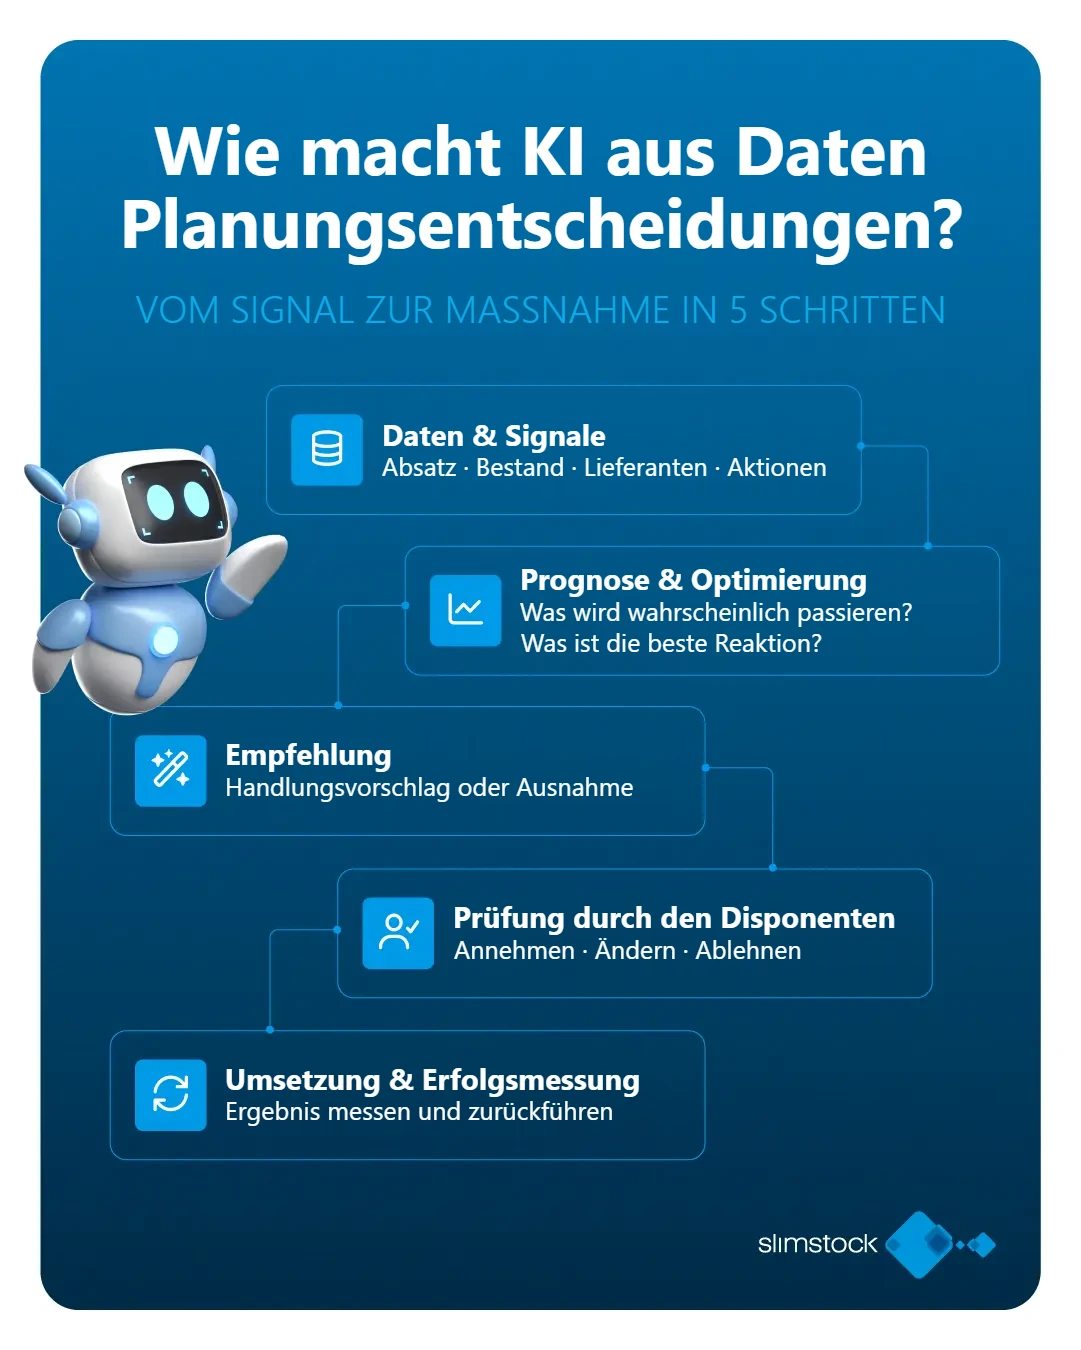
So werden Daten zu fundierten Entscheidungen: der Prozess in 5 Schritten
Jede sinnvolle Anwendung von KI in der Planung folgt in etwa derselben Kette. Eine Aufschlüsselung zeigt, wo ein Projekt wahrscheinlich ins Stocken gerät.
- Daten und Signale. Absatz- und Auftragshistorie, Bestände, offene Bestellungen, Lieferantenbestätigungen, Aktionen und andere bekannte Ereignisse. Saubere Daten sind besser als viele Daten.
- Prognose oder Optimierung. Ein Modell schätzt entweder ein, was wahrscheinlich passieren wird, oder ermittelt die beste Reaktion innerhalb der geschäftlichen Rahmenbedingungen. Oft macht es beides, in dieser Reihenfolge.
- Empfehlung oder Warnung. Das Ergebnis erscheint als Handlungsvorschlag oder als Ausnahme, die jemand prüfen muss, jeweils mit nachvollziehbarer Begründung.
- Prüfung durch den Disponenten. Routineempfehlungen innerhalb vereinbarter Toleranzen werden automatisch oder gebündelt freigegeben. Ausnahmen gehen an einen Disponenten, der sie annehmen, ändern oder ablehnen und die Begründung dokumentieren kann.
- Umsetzung und Erfolgsmessung. Die Entscheidung wird umgesetzt und das Ergebnis mit den Erwartungen verglichen. Das fließt zurück in die Daten und in die Regeln darüber, was automatisiert werden kann.
Wenn KI-Projekte enttäuschen, ist Schritt zwei selten das Problem. Häufiger ist es Schritt eins, weil die Daten nicht vertrauenswürdig sind, oder Schritt vier, weil Planer nicht erkennen können, warum das System etwas empfohlen hat, und sie daher in einer Tabellenkalkulation einen Workaround finden.
Beginnen Sie mit der Entscheidung, nicht mit dem Modell
Donato Masi und seine Kollegen haben sich mit KI-gestützter dynamischer Preisgestaltung für hochwertige Produkte beschäftigt, die innerhalb eines festen Zeitfensters verkauft werden müssen (Chen, Hu, Qi und Masi, 2026). Mich interessiert weniger die Preisgestaltung selbst als vielmehr der Aufbau des Modells. Es nutzt seine Einschätzung, wohin sich die Angebotspreise entwickeln, um zu jedem Zeitpunkt den niedrigsten Preis festzulegen, den es akzeptieren sollte. Deuten die Preise auf einen Anstieg hin, wartet es ab. Deuten sie auf einen Rückgang hin, passt es seinen Schwellenwert an, je näher die Frist rückt. Die Prognose ist nur deshalb nützlich, weil sie an eine Entscheidung mit einer Frist geknüpft ist.
Planungsteams gehen oft genau umgekehrt vor. Sie vergleichen die Prognosegenauigkeit verschiedener Modelle, wählen das Modell mit dem geringsten Fehler und gehen davon aus, dass das Unternehmen davon profitiert. Doch eine etwas genauere Prognose für Artikel, auf die niemand reagiert, ist weniger wert als eine gröbere Prognose, die Ihnen drei Wochen früher signalisiert, dass Sie eine Bestellung vorziehen oder Bestände zwischen Standorten umlagern sollten. Entscheidend ist, was Sie aufgrund der Prognose anders machen würden.
Die Datenbasis: Was zuerst vorhanden sein muss
Transparenz geht vor
Eine der nützlichsten Studien, die ich zu diesem Thema gelesen habe, hat überhaupt nichts mit KI zu tun. Kamble, Clegg, Masi und Al-Bazi (2024) arbeiteten mit einem kleinen, traditionellen Hersteller zusammen, der seine Produktionsaufzeichnungen auf Papier führte. Statt eine alte Handpresse zu ersetzen, rüsteten sie diese mit einem günstigen Näherungssensor und einem Mikrocontroller aus, um jeden Zyklus und jeden Stillstand zu erfassen, und speisten die Daten in ein Dashboard ein. Zum ersten Mal konnte das Unternehmen auf Basis dessen planen, was tatsächlich in der Fertigung geschah, und nicht auf Basis dessen, woran sich die Mitarbeitenden erinnerten.
Das Know-how war bereits vorhanden, es fehlte ein klarer Überblick darüber, was vor sich ging. Viel größere Unternehmen haben dasselbe Problem, nur mit „ausgefeilterem“ Papier: Wiederbeschaffungszeiten, die seit dem Lieferantenwechsel niemand mehr geprüft hat, Bestandsdaten, die langsam abweichen, und eine durch Fehlmengen verzerrte Absatzhistorie, sodass das, was nach schwacher Nachfrage aussieht, in Wirklichkeit mangelnde Verfügbarkeit ist. Wenn Sie ein KI-Modell darauf ansetzen, lernt es Ihre Fehler und wiederholt sie mit großer Überzeugung. Wie Professor Masi es ausdrückt:
„KI macht gute Daten nicht überflüssig. Sie erhöht den Preis für schlechte Daten.“
Für manche Unternehmen wäre der beste Einsatz des KI-Budgets im nächsten Jahr das Fundament darunter: Stammdaten bereinigen, Wiederbeschaffungszeiten aktuell halten und den tatsächlichen Bedarf erfassen, einschließlich der durch Fehlmengen entgangenen Umsätze.
Nicht jeder Artikel verhält sich gleich
Die Segmentierung steht seit Langem im Mittelpunkt von Slimstocks Ansatz zur Bestandsplanung, und Masis Forschung kommt aus einer anderen Richtung zum selben Ergebnis. In Zusammenarbeit mit einem Versorgungsunternehmen zeigten er und seine Co-Autoren, dass Infrastrukturprojekte nach ihrem Bedarfsprofil und nicht nur nach ihrer Art priorisiert werden sollten und dass wiederkehrende Arbeiten effizienter werden, wenn man sie als wiederkehrend behandelt (Masi et al., 2018). Dasselbe gilt für den Bestand. Ein schnell drehender Verbrauchsartikel, ein saisonales Sortiment und ein Ersatzteil, das sich zweimal im Jahr verkauft, brauchen mehr als nur unterschiedliche Prognosen. Sie benötigen unterschiedliche Servicelevel, unterschiedliche Überprüfungszyklen und unterschiedlich viel Aufmerksamkeit der Disponenten.
Es ist verlockend, ein einziges ausgeklügeltes Modell über das gesamte Sortiment laufen zu lassen und es alles regeln zu lassen. Doch so clever das Modell auch ist, es bleibt eine Einheitsstrategie. Wo KI wirklich helfen könnte, ist die Neuklassifizierung der Artikel in jedem Planungszyklus. Sie erkennt, wenn ein Artikel in ein anderes Segment wechselt, und passt die Strategie ebenso an wie die Mengen.
Prozess und Verantwortlichkeit
Jede Empfehlung braucht einen Verantwortlichen, eine Regel für die automatische Freigabe und einen klaren Eskalationsweg für Ausnahmen. Fehlt das, kommt mit der KI nur eine zweite Meinung hinzu, in einem Prozess, der schon die erste kaum umsetzt.

Die Menschen mitnehmen: Disponenten und KI im Zusammenspiel
Die menschliche Seite entscheidet meist darüber, ob all das langfristig funktioniert. In einer verwandten Studie zur digitalen Transformation eines kleinen Herstellers wurde der Wandel ebenso als Veränderung bei Menschen und Prozessen wie bei den Systemen verstanden (Panchal et al., 2024).
Das ist in der Planung besonders wichtig. Ein Disponent mit fünfzehn Jahren Erfahrung wird Entscheidungen nicht an ein System abgeben, das er nicht hinterfragen kann, und das sollte er auch nicht. Wenn die Mitarbeitenden nicht nachvollziehen können, warum das System etwas empfiehlt, werden sie es nicht nutzen. Sie überschreiben es in einer Tabellenkalkulation, und das Unternehmen bezahlt am Ende für zwei Planungsprozesse.
Wo Automatisierung sinnvoll ist
Die routinemäßige Nachschubdisposition für stabile Artikel mit hohem Absatzvolumen, mit verlässlichen Daten und Empfehlungen innerhalb vereinbarter Toleranzen, ist genau die Art von Arbeit, die ein System übernehmen sollte. Die Automatisierung verschafft den Disponenten mehr Zeit für die Entscheidungen, bei denen sie wirklich etwas bewirken.
Wo Expertenurteil gefragt ist
Neue Produkte ohne Verkaufshistorie, Aktionen oder Ereignisse, die das System noch nicht kennt, Lieferantenprobleme, teure Artikel oder Artikel mit langer Wiederbeschaffungszeit sowie Fälle mit widersprüchlichen Signalen. Diese sollten bewusst an einen Disponenten gehen, als fester Bestandteil der Prozessgestaltung.
Wie Disponenten Entscheidungen hinterfragen und übersteuern
- Treiber anzeigen. Jede Empfehlung sollte zeigen, was sich geändert hat und warum, sei es die Nachfrageannahme, die Vorlaufzeit oder die Einschränkung, die den Prozess aufhält.
- Nach dem Grund fragen. Übersteuerungen sollten schnell vorgenommen werden, mit einem kurzen Begründungscode, damit alle daraus lernen können.
- Übersteuerungen nachverfolgen. Überprüfe, ob Übersteuerungen die Ergebnisse verbessern oder verschlechtern. Gute Übersteuerungen sollten in das Modell und die Regeln einfließen; schlechte zeigen, wo noch an Schulung oder Vertrauen gearbeitet werden muss.
- Die Grenze im Zeitverlauf verschieben. Je mehr Erkenntnisse sich ansammeln, desto mehr Entscheidungstypen können von der Überprüfung zur automatischen Akzeptanz übergehen und manche müssen vielleicht wieder zurückversetzt werden.
Die Aufgabe des Disponenten verändert sich. Er verbringt weniger Zeit mit Rechnen und mehr Zeit mit Hinterfragen. Bei den verbleibenden Aufgaben, etwa der Beurteilung einer Aktion, die das System noch nie gesehen hat, der Zusammenarbeit mit einem schwächelnden Lieferanten oder dem Hinterfragen einer Annahme in der Absatz- und Bestandsplanung (S&OP), kommt es auf gute Disponenten am meisten an.
KI-gestützte und autonome Planung sind zwei verschiedene Dinge
Diese beiden Begriffe werden oft verwechselt. Bei der KI-gestützten Planung erkennt das System Probleme, erstellt Prognosen, testet Optionen und empfiehlt Maßnahmen, während Menschen die Richtlinien festlegen, Ausnahmen bearbeiten und die Verantwortung für die Ergebnisse behalten. Bei der autonomen Planung führt das System Entscheidungen von Anfang bis Ende aus, ohne dass jemand sie prüft.
Autonomie kann bei eng gefassten, gut verstandenen Entscheidungen mit verlässlichen Daten, klaren Grenzen und guter Erfolgsmessung funktionieren, etwa bei der oben beschriebenen routinemäßigen Nachschubdisposition. Wird sie jedoch auf einen gesamten Planungsprozess angewendet, nimmt sie ihm den Kontext und die Verantwortlichkeit, auf die gute Planung angewiesen ist. Und kein Modell gleicht schlechte Daten oder einen fehlerhaften Prozess aus.
Drei Fragen, bevor Sie KI in der Lieferkettenplanung einsetzen
Wenn das Thema KI in der Planung das nächste Mal aufkommt, würde ich vorschlagen, die Technologie zunächst beiseitezulassen und hier anzufangen:
- Welche Entscheidung wird sich dadurch ändern, und wer ist dafür verantwortlich?
- Sind die zugrunde liegenden Daten eine Tatsache oder eine Gewohnheit?
- Werden meine Planer:innen verstehen, warum das Modell bestimmte Empfehlungen ausspricht, und können sie diese hinterfragen?
Wenn Sie alle drei Fragen beantworten können, kann KI einen echten Unterschied für Ihre Planung machen. Wenn nicht, beginnen Sie damit, Daten und Prozess in Ordnung zu bringen. Das ist weniger aufregend als ein neues Modell, aber genau das macht das Modell erst profitabel.